เจาะลึก Orchestrator: สถาปัตยกรรม Hybrid AI Routing ของเรา
บทความนี้เกี่ยวกับ Autobahn Bot ซึ่งตอนนี้หยุดปรับปรุงชั่วคราว สิ่งที่บทความเล่าจึงยังใช้งานไม่ได้จนกว่าจะเปิดอีกครั้ง หน้าผลิตภัณฑ์
เจาะลึก Autobahn Orchestrator วิธีที่เราวิเคราะห์เจตจำนง, Route งานไปยังโมเดลเฉพาะ, และปรับการใช้ Token ให้เหมาะสมเพื่อลดต้นทุนการพัฒนาลง 68%
เจาะลึก Orchestrator: สถาปัตยกรรม Hybrid AI Routing ของเรา
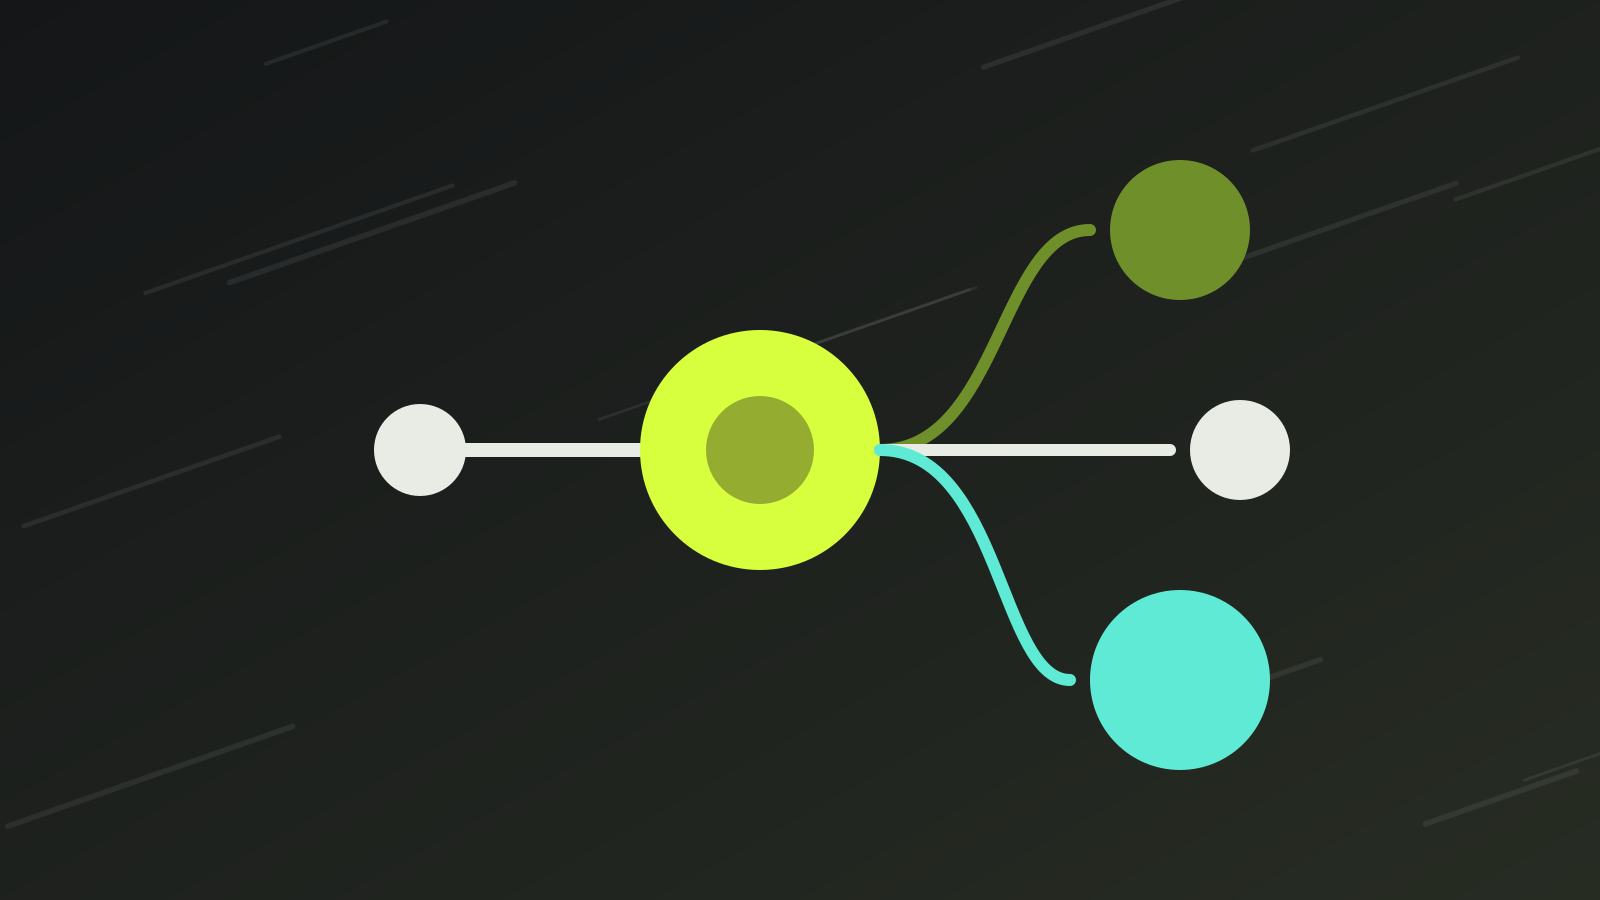
"Orchestrator" คือสมองของแพลตฟอร์ม Autobahn มันไม่ใช่โมเดลเดียว แต่เป็นระบบของตัวจำแนก (Classifier) และ Router ที่ออกแบบมาเพื่อแก้ปัญหา Trilemma ของ AI Engineering: ความเร็ว (Speed), คุณภาพ (Quality), และต้นทุน (Cost)
คุณไม่สามารถได้ทั้งสามอย่างด้วยโมเดลเดียว Orchestrator ช่วยให้เราทำได้โดยการสลับ Engine เบื้องหลังแบบไดนามิก
Routing Pipeline
เมื่อคุณส่งข้อความใน Autobahn มันจะผ่าน Pipeline การวิเคราะห์ที่ใช้เวลาต่ำกว่า 50ms:
- 1การจำแนกเจตจำนง (Intent Classification): โมเดล BERT ขนาดเล็กที่ผ่านการ Fine-tune จะวิเคราะห์ Prompt ของคุณ มันคือคำถาม? คำขอสร้างโค้ด? หรืองาน Debug?
- 2การประเมินความซับซ้อน (Complexity Estimation): เราคำนวณ "Cognitive Load Score"
- 3การกำหนดขอบเขตบริบท (Context Scoping): เรากำหนดว่าไฟล์ไหนที่เกี่ยวข้อง เราต้องการแค่ไฟล์ที่เปิดอยู่ หรือทั้งโฟลเดอร์
src?
การกระจายตัวแบบ 70/20/10
Telemetry ของเราแสดงรูปแบบที่สม่ำเสมอในพฤติกรรมของนักพัฒนา:
- 70% ของงานเป็นเรื่องเล็กน้อย (Trivial): (เปลี่ยนชื่อ, แก้ไขเล็กๆ น้อยๆ, Boilerplate)
- Routing: Local Models หรือ Flash Models
- ต้นทุน: ~$0.00
- 20% ของงานเป็นระดับปานกลาง (Moderate): (เขียนฟังก์ชัน, Debug พื้นฐาน)
- Routing: Mid-tier models (GPT-4o Mini, Claude Haiku)
- ต้นทุน: ต่ำ
- 10% ของงานมีความซับซ้อน (Complex): (สถาปัตยกรรม, Debug เชิงลึก, ความปลอดภัย)
- Routing: SOTA Models (Claude 3.5 Sonnet, GPT-4o)
- ต้นทุน: พรีเมียม
มูลค่าทางธุรกิจของ Routing
สำหรับ CTO สถาปัตยกรรมนี้คือความแตกต่างระหว่างกลยุทธ์ AI ที่ขยายขนาดได้ (Scalable) กับหลุมพรางทางการเงิน
ถ้าคุณใช้ GPT-4o สำหรับทุกอย่าง คุณกำลังจ่ายแพงเกินไปสำหรับ 70% ของคำขอของคุณ คุณกำลังใช้ Supercomputer เพื่อแก้คำผิด
[!IMPORTANT] ความคุ้มค่า: ด้วยการ Route งานเล็กน้อยไปยังโมเดลที่ถูกกว่า Autobahn ลดต้นทุนเฉลี่ยต่อ Token ลงได้ประมาณ 68% เมื่อเทียบกับการสมัครสมาชิก GPT-4o เพียวๆ
การ Implement ทางเทคนิค
Orchestrator สร้างขึ้นบนสถาปัตยกรรม Event-driven ที่รองรับ Throughput สูง เราใช้: Edge Computing: การจำแนกเจตจำนงเกิดขึ้นใกล้กับผู้ใช้มากที่สุด Vector Caching: เรา Cache คำถามและคำตอบที่พบบ่อย ถ้าคุณถามว่า "จัดกึ่งกลาง Div ยังไง?" เราจะส่งคำตอบที่ Cache ไว้และตรวจสอบแล้วให้ทันที โดยไม่มีต้นทุน Inference
นี่คืออนาคตของโครงสร้างพื้นฐาน AI: เลเยอร์ Routing อัจฉริยะที่ซ่อนความซับซ้อนของโมเดลเบื้องหลังไว้
ทีมวิศวกรรมหลักของ Autobahn ส่งมอบแซนด์บ็อกซ์ที่เสถียรและโครงสร้างพื้นฐานระดับ Edge